안녕하세요, 실험하고 검증하는 iOS 개발자 박현규입니다.
qwqwqw4756@gmail.com
실험하고, 신뢰할 수 있게 검증합니다.
실험 전에 "무엇이 나아지면 성공인가"를 수치로 먼저 정하고, 후보를 같은 조건에서 비교합니다. 한 프로젝트에서 51개 실험과 181개 모델을 비교했고, 알약 사진 500장을 직접 수집해 검증하고 최저 사양 기기인 iPhone 12에서 성능을 측정해 개선했습니다.
판단의 기준을 사용자와 현업에서 찾습니다.
전혀 모르던 간호 도메인에서 인터뷰와 설문으로 팀의 목표를 정의했습니다. 매일의 실험을 ADR로 남겨 팀원들과 의사결정하고, 현업 멘토님들께 평가받았습니다.
출시 후에는 사용자 데이터로 확인합니다.
출시 전 검증이 실제 사용자의 반응까지 보장하지는 않기에, 출시 전에 서비스의 목표를 북극성 지표로 정하고 GSM(Goal, Signal, Metric) 체계로 이를 측정할 분석 지표를 설계합니다. 설계한 지표는 테스트 플로우로 실측 대조해 데이터가 정확히 쌓이는지 확인하고, 출시 후에는 직감이 아닌 사용자 데이터로 제 판단을 확인합니다.
- Education
- 숭실대학교 소프트웨어학부 학사 졸업 예정 2021.03 입학
- Activity
- 소프트웨어학부 학생회 2021.03 - 2023.02
창의적공학설계 전시회 우수상 2021.12
공군 AI 해커톤 참가 2024.04
UMC 8기 숭실대 iOS 파트 2025.03 - 2025.08
오픈소스 WhisperLive(GitHub 3.6k★) iOS 클라이언트 코드 기여, Lecture2Quiz 2025.03 - 2025.06
숭실대 소프트웨어 공모전 총장상, 한땀한땀 2025.08.18
UMC 8기 데모데이 대상, 다이버리 2025.08.23
숭실대 IT프로젝트 공모전 우수상, 한땀한땀 2025.11.22
2025 SW 인재 페스티벌 SW중심대학 우수작품관 숭실대 대표 전시 (과학기술정보통신부 주관), 한땀한땀 2025.11.27
AI.SW마에스트로 17기 (과학기술정보통신부, 정보통신기획평가원 주관) 2026.06 - 현재 - Link
- github.com/ParkMazorika
velog.io/@mazorika
NurseMate AI.SW마에스트로 17기 · 3인 팀 · 2026.06 - 현재
간호사를 인터뷰하고 설문하며 문제를 정의했고, 북극성 지표를 설계해 사용자 활동을 분석했습니다. 이 지표를 개선하기 위해 51개의 실험을 돌려 181개의 모델을 학습시켰습니다. 학습한 모델은 Core ML로 iOS에 이식했고, 다양한 기기에서 RAM과 GPU 사용량을 분석하며 모델별로 연산 유닛(ANE, GPU, CPU)을 나눠 적재하는 메모리 최적화를 진행했습니다. 그 결과 저성능 기기에서도 사용자 경험을 보장하고, 기존 타 서비스 기준 평균 2분 이상 걸리던 알약 식별 시간을 1분 이내로 줄였습니다.
설명
입원 환자가 가져온 약(지참약)을 간호사가 하나씩 검색 앱에서 대조하느라 한 번에 10~20분이 걸리는 문제를 보았습니다.
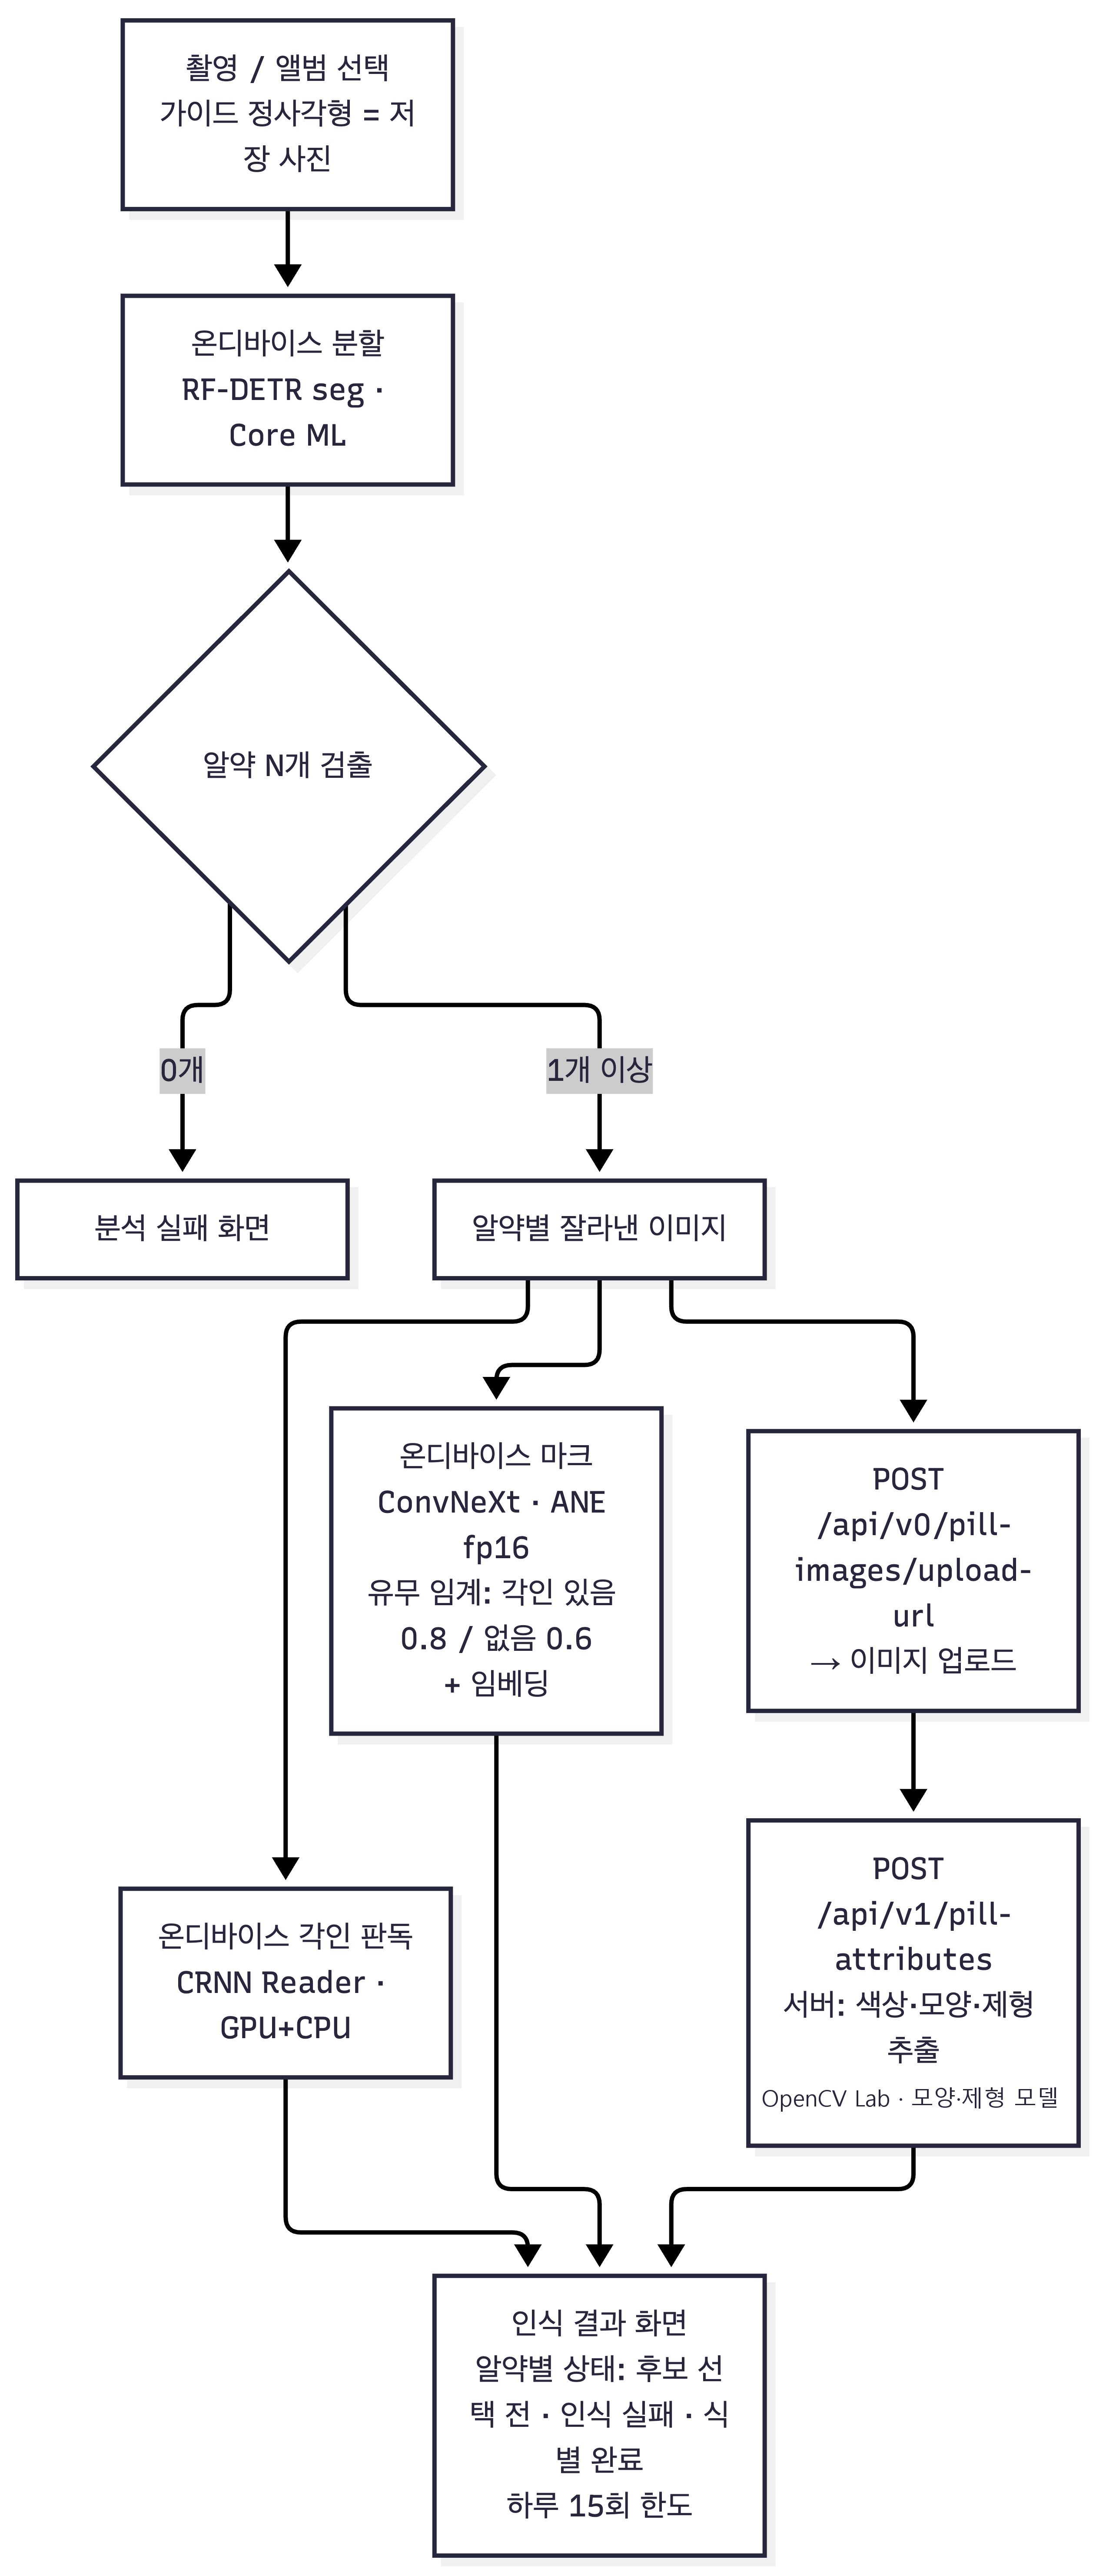
NurseMate는 지참약 봉투를 찍으면 안에 든 알약을 찾아 식약처 등록 25,246종 중 후보를 보여 주는 앱입니다.
알약 표면의 음각 각인을 폰에서 직접 읽는 온디바이스 판독 모델이 핵심 차별점입니다. 이 프로젝트에서 각인 판독 AI와 iOS, watchOS를 맡았습니다.
주요 기능
- 온디바이스 알약 검출과 각인 판독
RF-DETR 분할로 알약을 잘라 내고, 직접 학습한 CRNN + CTC 모델로 각인을 24방향 × 6배율로 읽어 가장 확신하는 글자를 선택 - 마크 판독과 임베딩 재정렬
ConvNeXt 마크 모델로 제조사 기호를 판별하고, 같은 모델의 특징 벡터로 후보 알약의 순위를 재정렬 - Core ML 실기기 최적화
마크 모델은 fp16 + Neural Engine, 각인 판독은 GPU와 CPU 두 레인으로 나눠 동시에 실행
핵심 수치
- 최종 후보 정답률 (실제 사용자 사진 기준)
1위 72.1% · 20위 안 86.8% - 각인 판독 (정밀도 90% 통과 사진 수, 감사셋 331장)
98장 → 241장 (약 2.5배) - 판독 시간 (알약 6개, iPhone 12)
9.2초 → 5.4초 (약 41% 단축) - 출시 초기 사용자
3,600명
App Storeapps.apple.com/kr/app/id6783877557 GitHubgithub.com/Two-Park-One-Bae/iOS
1
기능
환자가 입원하면 간호사는 환자가 집에서 먹던 약(지참약)을 전부 파악해야 합니다. 지참약은 약 이름 없이 투명 봉투에 담겨 오고, 산화와 오염 때문에 봉투를 뜯을 수 없습니다. 그래서 겉면의 각인, 모양, 색을 보고 검색 앱에서 하나씩 대조합니다. 한 번에 10~20분이 걸리고, 설문에 응한 간호사 50명 중 56%가 확신 없이 확인한 적이 있다고 답했습니다.
NurseMate는 봉투째 찍은 사진에서 알약을 하나씩 찾아, 식약처 등록 25,246종 중 후보를 보여 줍니다. 간호사는 후보를 고르거나, 각인과 색을 고쳐 후보를 좁힙니다.
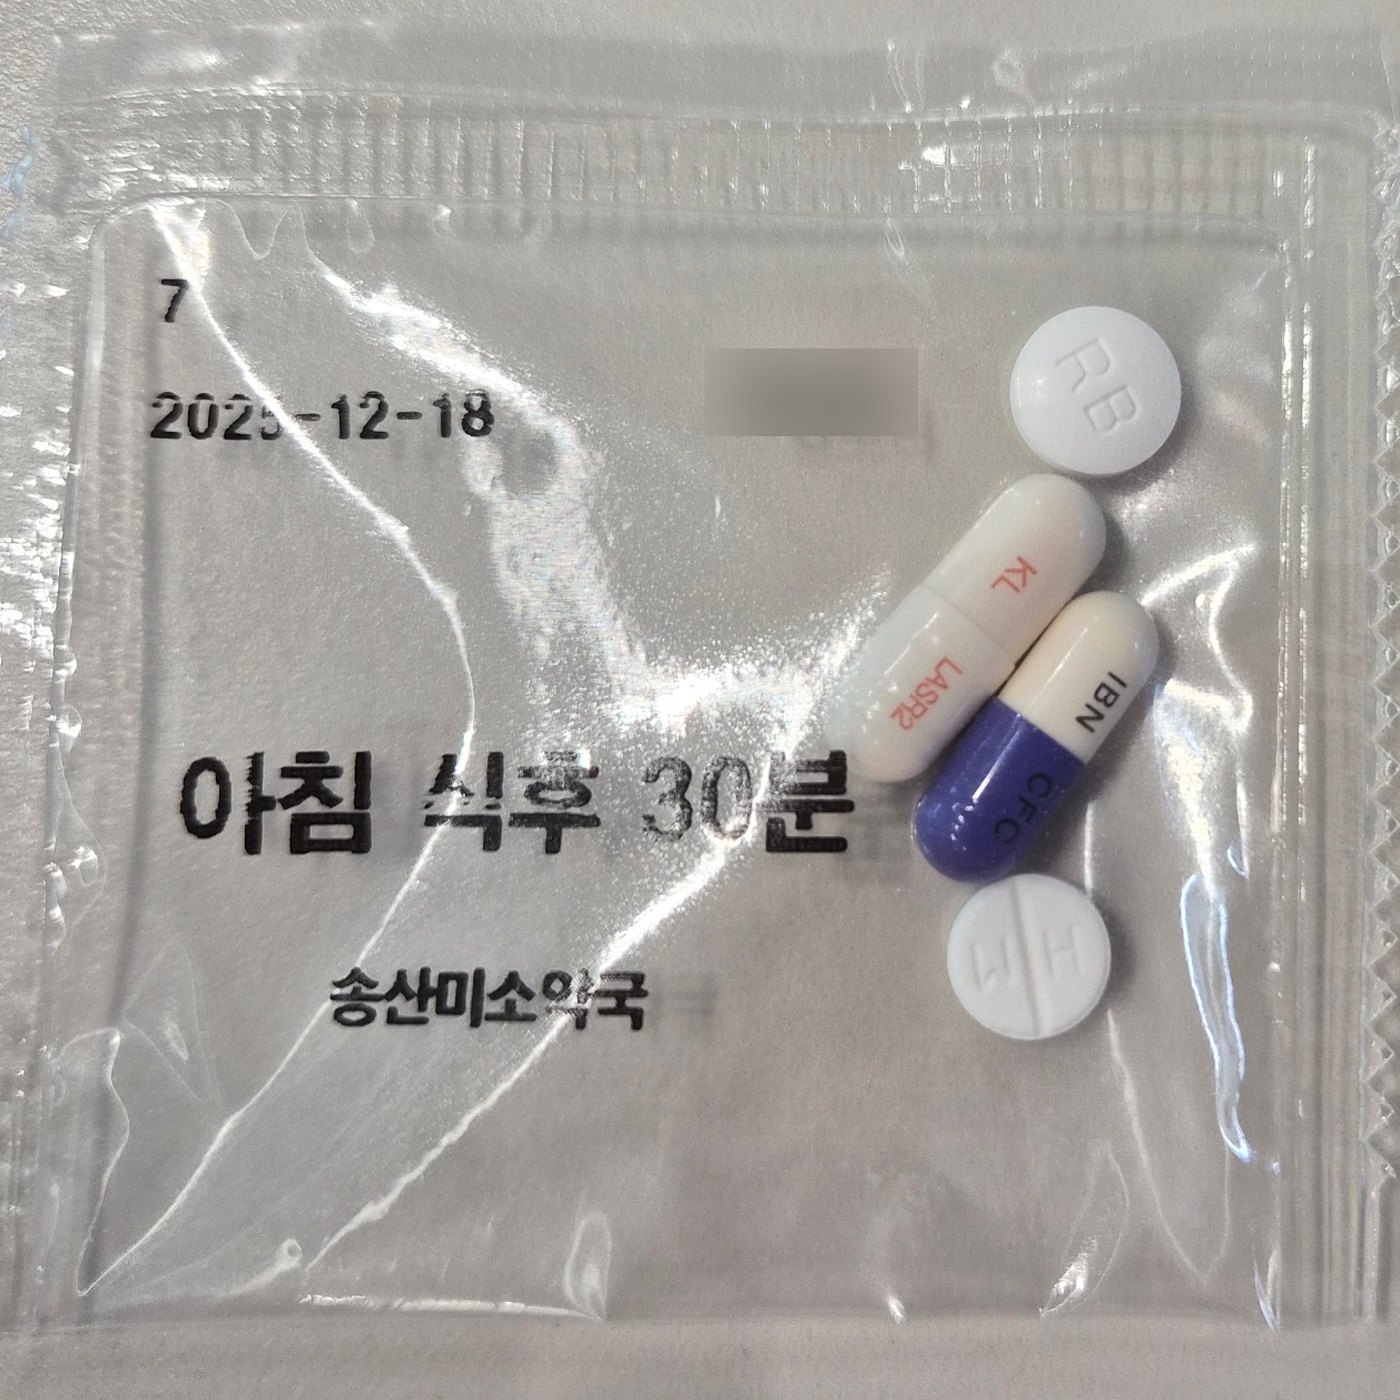
img/yakpoji.jpg
표시한 단계는 제가 맡은 부분입니다. 후보 검색과 임베딩 재정렬은 서버에서 돌고, 임베딩은 폰에서 뽑아 12KB만 전송합니다. 속성 추출은 백엔드 팀원이 담당했습니다.
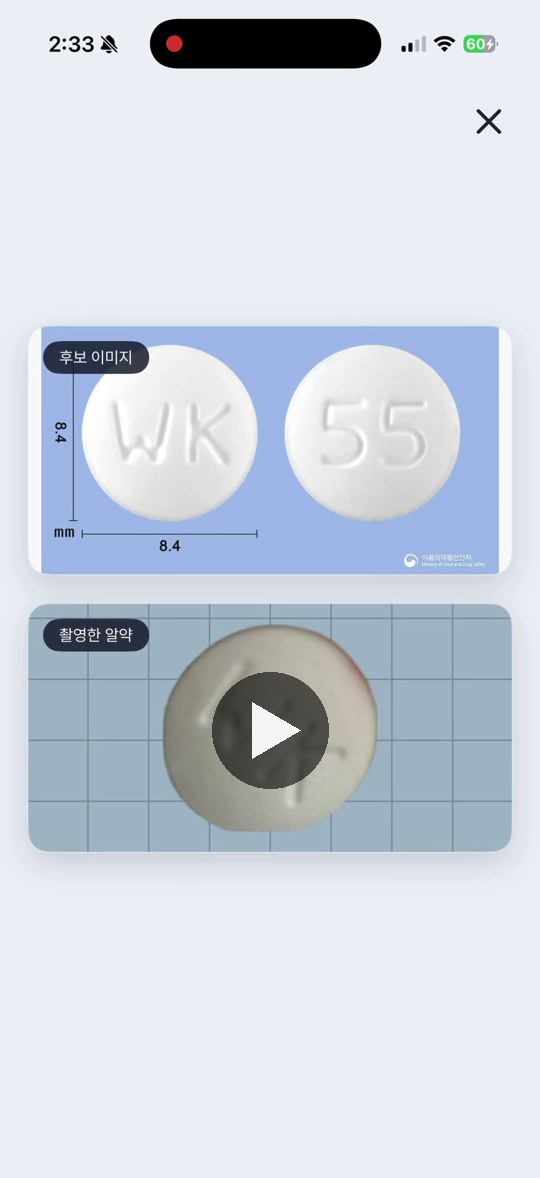
2
Trouble
각인은 글자가 아닌 음각
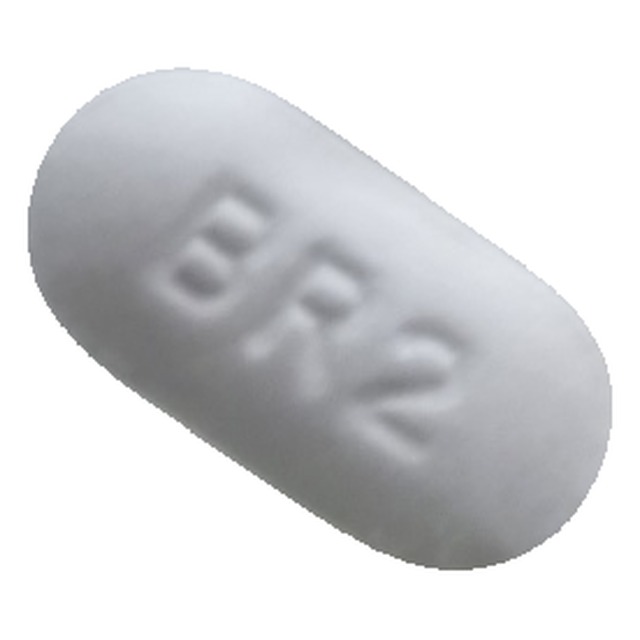
각인은 표면을 눌러 새긴 음각이라 배경과 색이 같고 그림자로만 보입니다. 일반 OCR은 밝은 배경 위의 어두운 글자를 전제로 해서 맞지 않았습니다. Tesseract로 읽었을 때 정확도는 0.7%였습니다.
해결 기성 OCR 대신 직접 학습한 판독기를 사용했습니다. 전처리 10종을 비교했고, 흔히 쓰는 이진화는 각인의 명암을 지워 가장 낮은 성능을 보였습니다.
글자 외에 제조사 마크도 존재
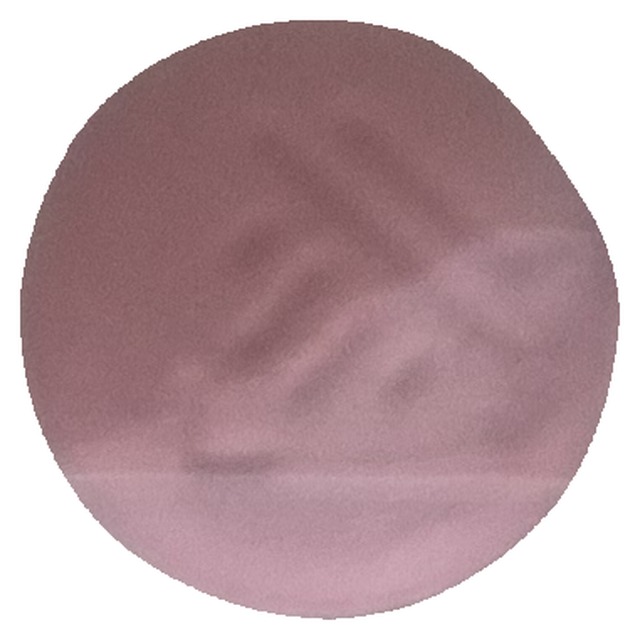
글자 대신 제조사 기호(마크)가 새겨진 알약도 많습니다. 흰색 원형 정제 4,919품목 중 647품목에 마크가 있고, 46품목은 마크가 유일한 단서입니다. 마크는 글자처럼 읽을 수 없고 종류가 200개가 넘으며, 작고 얕아 폰 사진에서 잘 보이지 않습니다.
해결 마크 유무와 종류를 판별하는 별도 모델(ConvNeXt)을 만들었습니다. 판독기에 마크 기능을 붙이는 시도가 일곱 번 실패했는데, 원인은 참조 사진의 앞뒤 면 배정 오류였습니다. 배정을 바로잡고 전용 모델로 바꿔 마크 유무 AUC를 0.82에서 0.99로 올렸고, 이 모델의 특징 벡터를 후보 재정렬에도 사용했습니다.
반짝이는 비닐 속 알약 인식
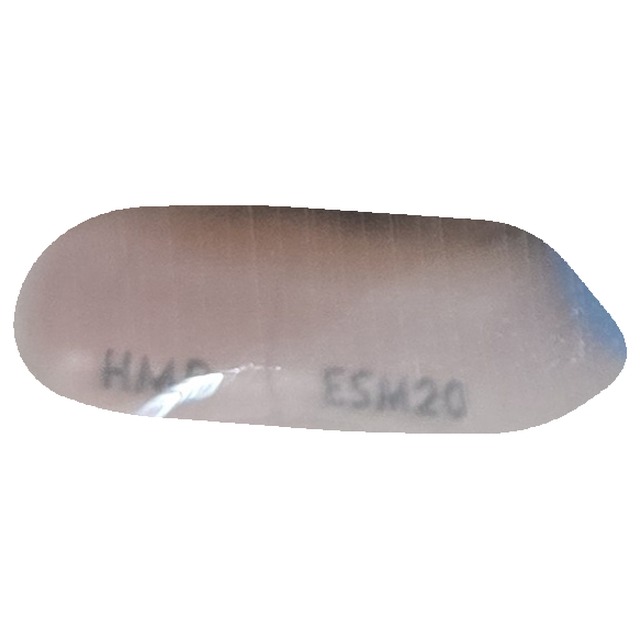
약포지 비닐 때문에 반사광과 주름이 생기고, 봉지의 인쇄 글자가 알약 위에 겹칩니다. 알약 하나는 사진에서 가로 200픽셀 정도입니다. 사람이 정답 없이 읽었을 때도 37.1%만 읽었고, 45.7%는 읽지 못했습니다.
해결 사람도 읽지 못하는 사진은 억지로 답하지 않고, 확실한 경우에만 답하도록 설계했습니다.
학습 데이터 부재
약포지 사진에 정답이 붙은 공개 데이터는 없었습니다. 식약처 참조 사진은 스튜디오에서 찍은 깨끗한 사진이라 폰으로 찍은 약포지와 많이 달랐습니다.
해결 사진을 직접 모으고 라벨링 도구를 만들어 평가셋을 구축했습니다(약포지 129장, 알약 291개, 559면). 이후 서비스 S3에 쌓인 실제 사용자 사진도 평가에 추가했습니다. 학습은 참조 사진을 약포지 촬영 조건에 맞게 변형하는 방식으로 진행했습니다.
오답이 허용되지 않는 의료 환경
의료 현장에서 쓰는 앱이라 틀린 답은 곧 신뢰 하락으로 이어집니다. Gemini 같은 상용 비전 언어 모델은 확률 없이 "확신한다"는 말만 돌려줬고, 확신한다고 한 답의 23.3%가 틀렸습니다. 확신도로 정답과 오답을 구분하는 능력도 AUC 0.50으로 무작위 수준이었습니다.
- 글자마다 확률이 나오는 모델을 직접 학습하고, 평가 지표를 "정밀도 90%를 지키며 몇 장에 답할 수 있는가"로 정했습니다.
- 사진에서 바로 약을 맞히는 종단간(E2E) 방식 대신, 읽어 낸 각인과 색, 모양을 그대로 보여 주고 사용자가 고칠 수 있게 했습니다.
온디바이스 실행
알약 한 면을 24개 방향과 6개 배율로 144번 읽고 가장 확실한 답을 고릅니다. 모델은 23.9MB로 작지만 면당 연산량이 404 GFLOP라 데스크톱 CPU로도 1.5초가 걸렸습니다.
해결 연산 장치 배정과 병렬화로 실기기 속도를 맞췄습니다. 자세한 과정은 앱 탑재 항목에 정리했습니다.
3
학습 데이터
직접 라벨링할 수 있는 실사진은 평가셋 규모가 한계였고, 학습용 수만 장은 확보할 수 없었습니다. 그래서 식약처 참조 사진을 실사진처럼 변형해 학습 데이터로 사용했습니다.
- 증강
참조 사진과 실사진의 차이를 먼저 측정하고, 약포지에서 실제로 생기는 현상만 합성했습니다.
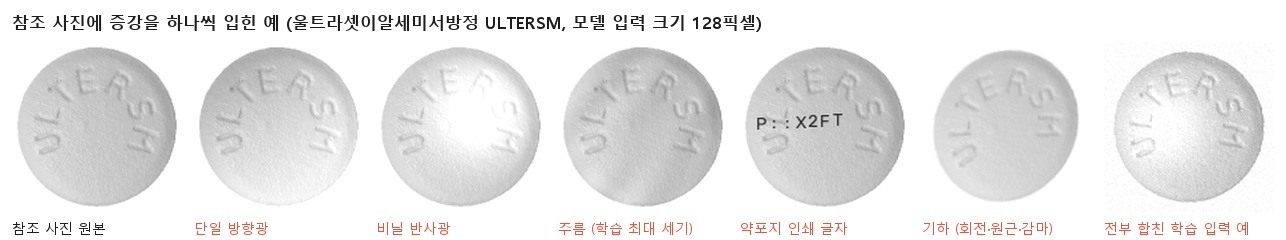
참조 사진에 증강을 하나씩 적용한 예. 실제 학습에서는 무작위 세기로 섞어서 적용(맨 오른쪽) - 문제
- 학습에 쓸 수 있는 사진은 식약처가 스튜디오에서 찍은 깨끗한 공식 사진뿐이라, 실제 폰으로 찍은 약포지 사진과 모습이 다름
- 접근
- 가정 대신 측정으로 증강 축 결정. 기준은 선명도(라플라시안 분산)와 밝기 표준편차
- 약포지에서 실제로 생기는 현상만 수식으로 합성. 알약 안쪽에만 적용하고 원본도 함께 학습
- 실험
1. 실사진과 참조 사진의 차이 측정
실사진 대 참조 사진 (중앙값) 항목 실사진 참조 사진 선명도 (라플라시안 분산) 459.8 343.9 밝기 표준편차 36.9 31.4 2. 측정 결과에 맞춰 약포지 현상만 합성
증강 축과 넣은 방법 축 넣은 방법 단일 방향광 한 방향으로 밝아지는 밝기 경사 추가 비닐 반사광 알약 안 임의 위치에 가우시안 형태의 밝은 점 추가 주름 사인파 1~3개를 겹친 얇은 줄무늬를 약하게 추가 약포지 인쇄 글자 날짜·이름 같은 글자를 알약 경계를 가로지르게 추가 기하 회전 ±20°, 원근, 감마 - 결과
- 실사진이 더 선명함 → 흐림·축소 증강 제외
- 정밀도 90% 통과: 기하 변형만 131면 → 조명·비닐 증강 추가 188면 (약 44% 향상)
4
각인 판독 모델
각인은 배경과 색이 같은 음각이고, 반짝이는 비닐의 반사와 주름 속에서 읽어야 합니다. 의료 현장이라 틀린 답을 걸러낼 수 있어야 하고, 폰에서 돌아야 합니다. 그래서 글자마다 확률이 나오는 CRNN + CTC 모델을 직접 학습하고, 아래 기법으로 성능을 높였습니다.
평가는 실사진 331장에서 진행했습니다.
- 모델 선택
기성 OCR과 비전 언어 모델을 같은 사진으로 비교한 뒤, CRNN + CTC를 직접 학습했습니다.
- 문제
- 각인은 음각이라 문서 OCR이 전제하는 "밝은 배경에 어두운 글자"가 아님
- 폰에서 동작해야 하고, 글자마다 확률이 필요
- 접근
- 공개 모델를 같은 사진, 같은 기준으로 비교
- 자체 모델은 금속 음각 문자를 CNN + 양방향 LSTM + CTC로 인식한 논문(Xiang, Wu, Zhou, IET Image Processing 2022) 참고
- 실험
-
기성 모델 비교 (같은 크롭 25장) 모델 정확 Gemini (비전 언어 모델) 40.0% Apple Vision 20.0% TrOCR 8.0% EasyOCR 4.0% Tesseract 0.0% - 자체 모델 완성 후 감사셋 331면에서 공개 OCR, VLM과 재비교
- 결과
-
공개 모델과 비교 (감사셋 331면, 공개 모델은 추가 학습 없음) 모델 정답 정밀도 90% 통과 직접 학습한 CRNN (24MB) 238면 (72%) 240면 HunyuanOCR (1.1B) 157면 (47%) 126면 PaddleOCR-VL (0.96B) 172면 (52%) 67면 공개 사전학습 CRNN (docTR, 학습 없이) 8면 (2.4%) 0면
- 구조 1
기울거나 휘어진 글자를 펴서 읽기 쉽게 만드는 모듈(TPS)을 추가했습니다.
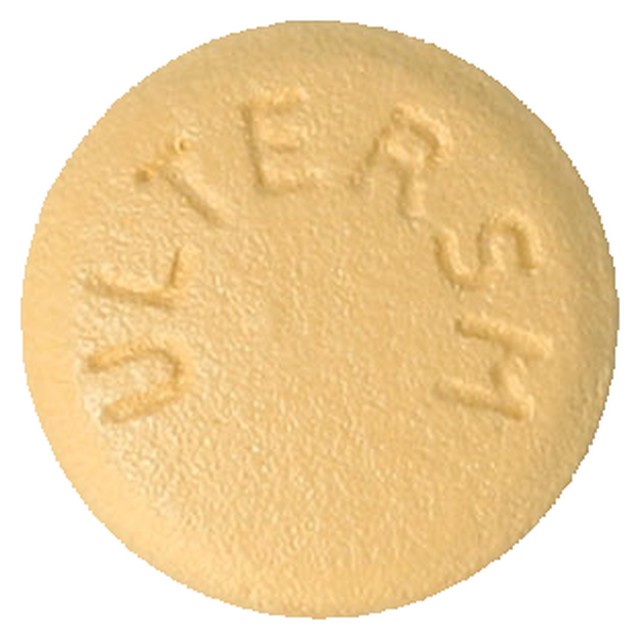
테두리를 따라 둥글게 새겨진 각인 예시. 울트라셋이알세미서방정(ULTERSM), 식약처 참조 사진 - 문제
- 첫 모델(20에폭)의 오답 사진 분석 → 글자가 기울거나 휘고 크기가 제각각
- CRNN은 고정된 격자로 읽어 이런 변형에 약함
- 접근
- 문자 인식 논문(RARE 2016, ASTER)의 TPS 정류기 적용
- 제어점 20개의 위치를 예측해 이미지를 변형한 뒤 인식
- 실험
- 기준 모델과 TPS 모델을 5시드씩 학습해 실사진 559면에서 비교
- 결과
- 정답 사진 수 평균 166장 → 187장 (약 13% 향상)
- 구조 2
줄 전체를 함께 보는 모듈(FRM)을 추가했습니다.
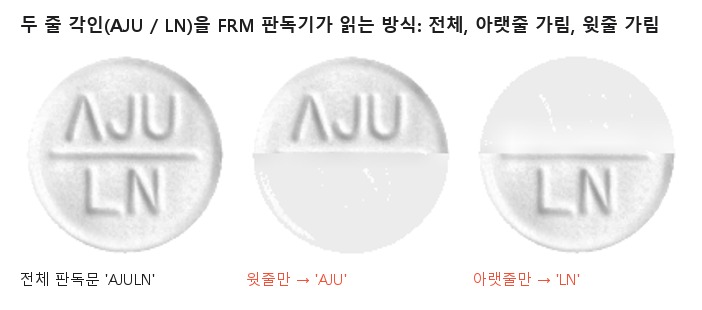
두 줄 각인(아주록손정, AJU / LN) 판독 결과. 전체 입력 시 AJULN, 한 줄씩 가리면 AJU와 LN - 문제
- CRNN은 이미지 높이를 압축해 한 줄로 만든 뒤 왼쪽부터 순서대로 읽음
- 한 글자를 읽을 때 줄의 나머지 정보를 활용하지 못함
- 두 줄 각인, 간격이 넓은 각인에서 누락 발생
- 접근
- 장면 문자 인식 논문 SVTRv2(2024)의 FRM 적용
- 행마다 가로 방향 자기어텐션을 적용해 줄 전체 정보를 반영
- 열마다 사용할 행을 선택하는 단계 추가
- 실험
- 감사셋 331면, 3시드
- 같은 논문의 SGM, 가로 어텐션을 뺀 축소판과 비교해 성능 향상 원인 확인
- 결과
- 정밀도 93% 통과 사진 118~126장 → 134~150장 (약 16% 향상) (3시드 범위)
- 방향
방향을 추정하지 않고, 24방향을 모두 읽어 가장 확신하는 답을 선택했습니다.
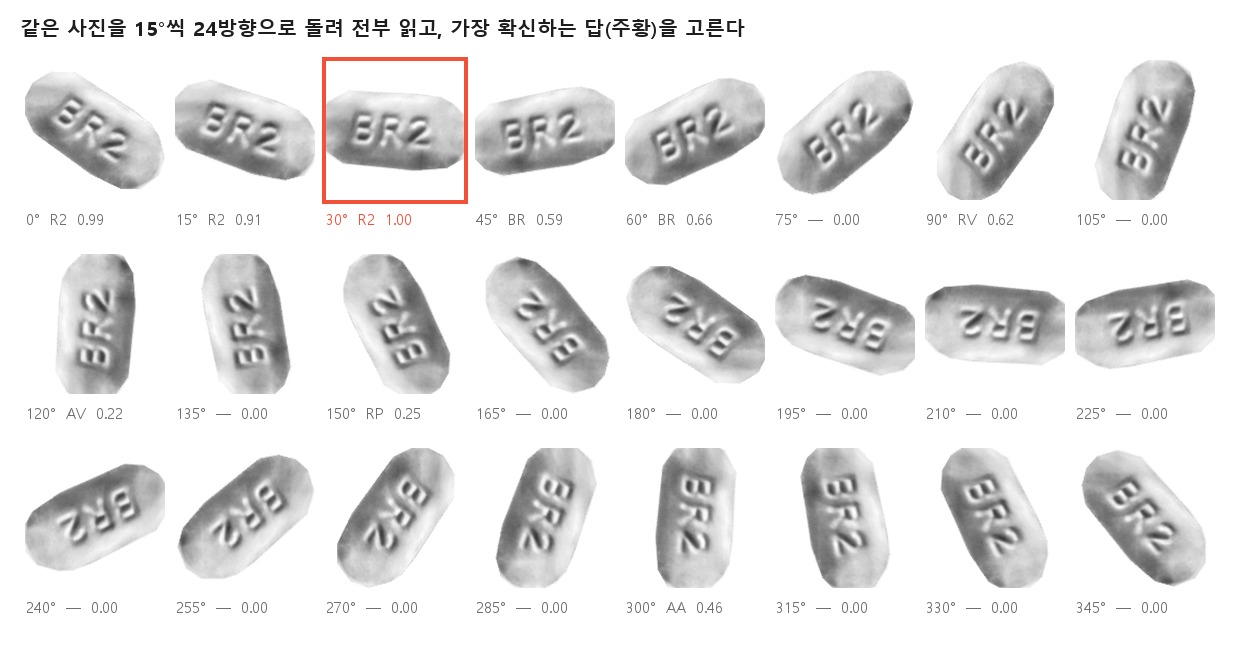
같은 알약을 24방향으로 읽은 결과. 30°에서 R2를 확신도 1.00으로 선택, 뒤집힌 방향은 대부분 답하지 않음 - 문제
- 판독기는 바로 선 글자로 학습했지만 실사진 각인은 방향이 제각각
- 4방향만 읽으면 잘못된 방향의 판독 결과가 후보에 섞임
- 방향 추정기(주성분 분석, TextSnake 방식)는 추정 자체가 부정확
- 접근
- 방향을 추정하지 않고 모든 방향을 읽은 뒤 확신도로 선택
- 상한 측정 결과 4방향 17.4% → 24방향 20.3%
- 같은 호출 수에서 방향 추정기보다 더 많은 방향을 읽는 쪽이 항상 우세
- 실험
- 학습은 회전 ±20°, 추론은 24방향 탐색으로 설계
- 같은 모델로 방향 수를 1, 4, 8, 12, 24, 144로 바꿔 측정
- 결과
- 정밀도 90% 통과: 1방향 0장 → 24방향 188장
- 144방향은 오히려 12장 감소 → 24방향 채택
방향 수별 정밀도 90% 통과 면 (시드 1, 6배율, 감사셋 331면) 방향 수 1 4 8 12 24 통과 면 0 87 135 166 188
- 확대
추가 학습 없이 6가지 배율로 확대해 읽는 확대 TTA를 적용했습니다.
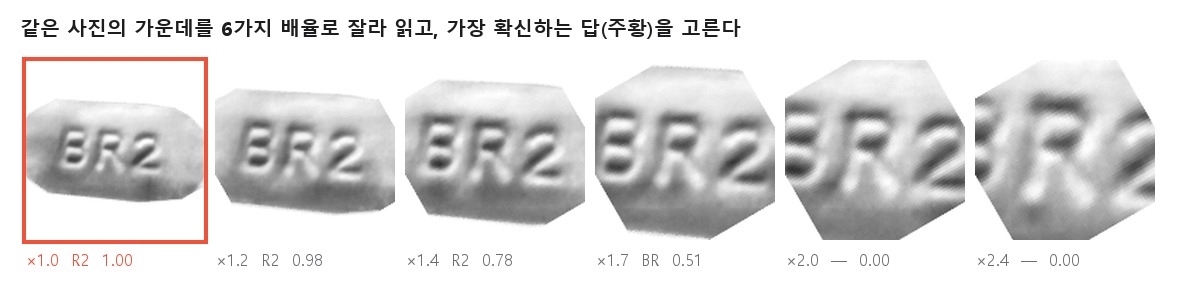
같은 알약을 6배율로 읽은 결과. 이 사진은 원본 배율에서 확신도가 가장 높고, 글자가 작은 사진은 큰 배율이 유리 - 문제
- 알약 전체를 정사각형으로 입력 → 글자가 차지하는 비율이 작음
- 접근
- 검출기 대신 이미지 중앙을 여러 배율로 잘라 읽는 방식으로 먼저 검증
- 답하지 못하던 사진이 읽히면 "글자가 작다"는 가설이 확인됨
- 실험
- TTA 배율 6개 × 24방향으로 읽고 가장 확신하는 답 선택
- 결과
- 정밀도 90% 통과 165장 → 188장 (약 14% 향상)
후보 재정렬
- 좁히기
읽은 글자로 후보를 줄이고, 남은 후보는 임베딩 유사도로 재정렬했습니다.
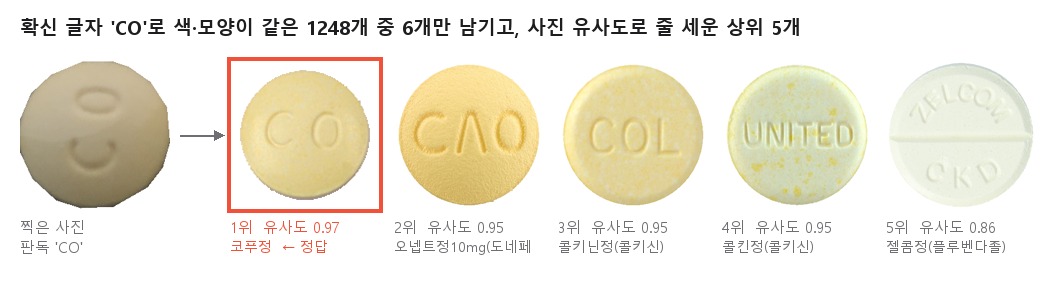
확신 글자 CO로 후보를 6개로 줄이고, 임베딩 유사도로 재정렬해 정답(코루정)이 1위가 된 예 - 문제
- 읽은 글자를 포함하는 각인의 알약이 모두 후보로 나옴 → 후보 중앙값 8개, 정답 순위 중앙값 3위 (실사진 229장)
- 접근
- 임베딩 유사도만으로는 각인을 대체하지 못했음 → 각인으로 좁힌 뒤 순위 재정렬에만 사용
- 실험
- 찍은 사진과 후보의 식약처 사진에서 특징 벡터를 추출해 코사인 유사도로 재정렬. 특징 모델 3종(ImageNet, DINOv2, 마크 모델) × 후보 범위 3종 비교
- 결과
- 정답 1위 비율 28.4% → 64.6% (실사진 229장)
- 정답 순위 중앙값 3위 → 1위 (평균 7.2위 → 3.5위)
5
앱 탑재
모델을 폰에 올리면서 변환 후 결과가 같은지, 어떤 연산 장치에서 돌릴지, 어떻게 병렬로 돌릴지를 iPhone 12와 iPhone 16 Pro에서 직접 측정해 결정했습니다.
- 변환 검증
앱에 들어가는 모델 세 개를 같은 절차로 변환하고, 연구 단계와 같은 결과를 내는지 확인했습니다.
- 문제
- 연구는 PyTorch, 앱은 Core ML → 변환과 fp16 축소 과정에서 결과가 달라질 수 있음
- 모델마다 구조가 달라 같은 변환이 모두 통하지 않음
- 접근
- 세 모델 모두 같은 순서로 확인: 그래프 구조 비교 → fp16 변환 시도 → 같은 사진으로 출력 대조 → 실기기 적재
- 실험
- PyTorch 모델과 Core ML 모델을 Netron으로 열어 그래프 구조 비교
- fp16과 fp32를 같은 사진으로 돌려 점수 차이와 판정 변화 비교
- 연구 코드와 앱의 전처리로 같은 사진을 넣어 출력 대조
- 결과
-
모델별 변환 결과 모델 검증 결과 탑재 형태 알약 검출 (RF-DETR 분할) fp32 기준 검출 202개 → 203개 중 200개 일치, 검출 영역이 연구 모델과 평균 98.9% 겹침 (IoU 0.989) fp32, GPU 각인 판독 (CRNN + CTC) fp32 기준 판정 변화 0건, 확신도 최대 차 0.0016 (실사진 331장) fp32, GPU + CPU 마크 판독 (ConvNeXt) fp32 111.7MB → fp16 55.9MB (50% 감소), 판정 변화 0건, 임베딩 코사인 유사도 0.99999 이상 fp16, Neural Engine
- 연산 장치
모델별로 CPU, GPU, Neural Engine 중 실행 장치를 측정해 결정했습니다.
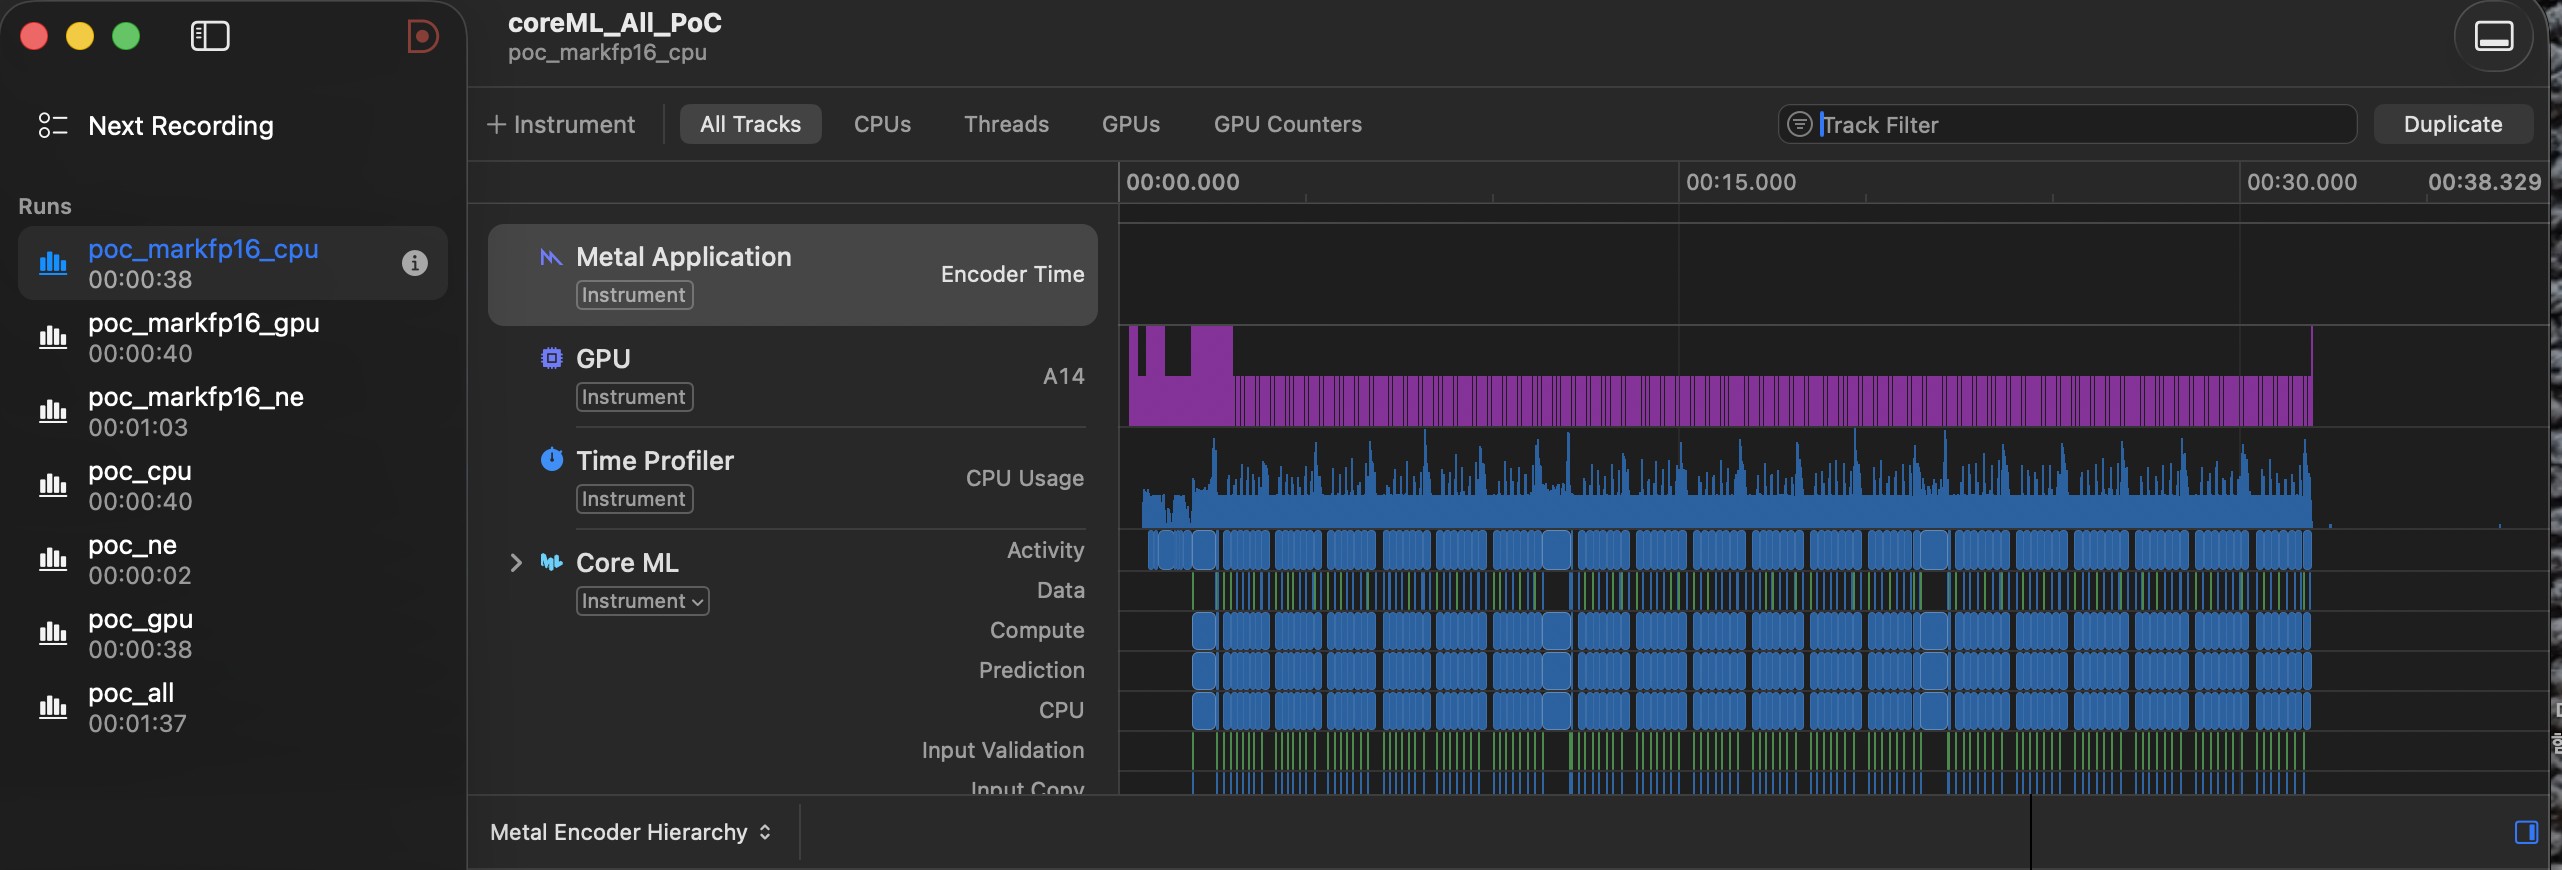
Instruments(Core ML 템플릿) 실행 트레이스. 설정별 실제 실행 장치 확인 - 문제
- Core ML의 실행 장치 자동 배정만으로는 실제 실행 장치와 속도, 메모리를 알 수 없음
- iPhone 12는 앱 메모리 한도가 약 2.1GB → 모델 하나가 1GB를 쓰면 다른 모델 적재 불가
- 접근
- 모델 5종을 설정별로 돌리며 시간과 메모리를 100ms마다 기록. 연산별 배정 장치는 MLComputePlan, 실제 실행 장치는 Instruments로 확인
- Neural Engine은 fp16에서만 쓸 수 있으므로 마크 모델은 Neural Engine 사용
- 실험
- fp32 모델 전체를 cpu / gpu / all / ne 설정으로 각 3회 측정
- 마크 fp16 모델을 ne / cpu / gpu 설정으로 각 4회 측정
- 결과
- 마크 모델 fp16 + Neural Engine: 추론 244ms → 60ms (75% 단축), 메모리 +630MB → +2MB
- fp32 모델은 Neural Engine 사용 불가 → 마크는 Neural Engine, 나머지는 all로 배정
- 병렬화
각인 판독을 GPU와 CPU 두 레인으로 나누고, 마크 판독을 Neural Engine에서 동시에 실행했습니다.
- 문제
- 판독 1장 9.2초 중 7초가 각인 판독 → 알약 6개 × 24방향 × 6배율을 순차 처리
- 접근
- 병목은 추론(알약당 약 1초) → 여러 연산 장치를 동시에 사용
- fp32 각인 모델은 CPU와 GPU 속도가 비슷 → 두 레인(CPU, GPU)을 동시에 운영
- 작업을 알약 단위가 아닌 배치(24방향) 단위로 분할 → 알약이 적어도 두 레인(CPU, GPU) 모두 활용
- 실험
- 레인 구성 3종 × 작업 단위 2종을 iPhone 12와 iPhone 16 Pro에서 측정
- 마크 모델(Neural Engine)과 각인 모델(GPU, CPU)을 동시에 실행
- 각인 모델을 GPU 레인과 CPU 레인으로 두 번 열고, 한 알약을 배율별로 나눈 배치 6개(배치마다 24방향)를 먼저 빈 레인이 하나씩 가져가 처리
- 각인 전처리(144개 회전·확대 이미지 생성)를 CPU 코어 수만큼 나눠 병렬 처리
- 결과
- 판독 1장: iPhone 12 9.2초 → 5.4초 (약 41% 단축), iPhone 16 Pro 3.4초 → 2.0초 (약 41% 단축)
- 알약 1개 기준 각인 판독 iPhone 12 41%, iPhone 16 Pro 47% 단축
6
결과
| 항목 | 위 기법을 적용하지 않은 기본 각인 모델 | 최종 각인 모델 |
|---|---|---|
| 정답 사진 수 | 161면 | 247면 |
| 정밀도 90% 통과 사진 수 | 98면 | 241면 |
TPS, FRM, 24방향 탐색, 확대 TTA, 60에폭 학습을 적용한 결과입니다. 기본 모델은 24방향, 최종 모델은 24방향 × 6배율로 측정했습니다.
| 항목 | 값 |
|---|---|
| 정답이 1위 (Hit@1) | 72.1% |
| 정답이 20위 안 (Hit@20) | 86.8% |
App Storeapps.apple.com/kr/app/id6783877557 GitHubgithub.com/Two-Park-One-Bae/iOS